自带防呆基因的汉字文化,不可能读错的《道德经》
2020-04-08
心得 / 汉字
自带防呆基因的汉字文化,不可能读错的《道德经》
副标题:汉字的防痴呆基因,是古人造字的大智慧,也是神传文化的要素
来源:
隐士申子源 2020-04-07 07:08:34
最近看到一段评论,非常有意思,给了很大的启发。
我们先看看这段评论的两种表达方式,如下:
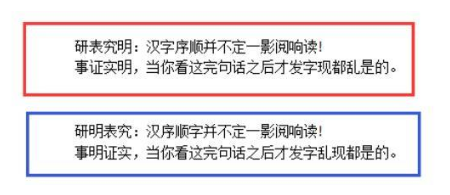
为了不让编辑器的智能识别系统发生短路,用截图的形式表达。
其实,明眼人都看出来,这段话的正确表达顺序如下:
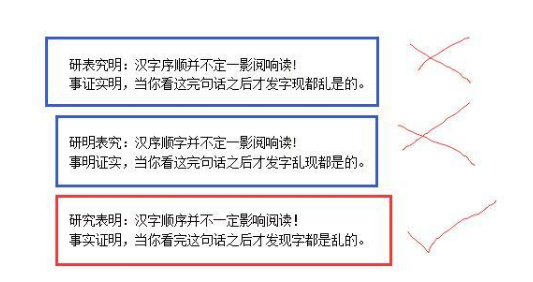
研究表明:汉字顺序并不一定影响阅读!
事实证明,当你看完这句话之后才发现字都是乱的。
这就是汉字的神奇之处,字体的顺序排错了,甚至多种乱排,却不影响人们去理解这段文字要表达的主题意思。
从这个角度就可以体会古代文言文那些文体,至今中国人还能够看得懂的大智慧吧。
这种效果,阿拉伯字,拼音,英语语境都是没有的效果。
也许专家会说,象形文字就是这个尿性,并不等于汉字文化就很高级。
反正高级不高级,先进不先进,我们姑且不争辩了,好用就行。
汉字的这种特征,类似现代工业设计的防痴呆设计。
很多电器的接口都有防痴呆设计的。
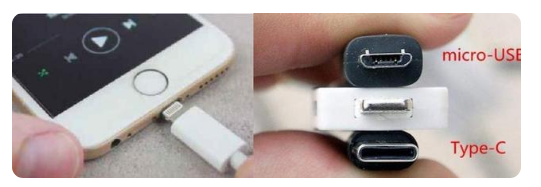
就是不管怎么样插,都不会插错,这就是防痴呆的工业设计。
这让申子源联想到古代的那些经书,比如大家比较熟悉的《道德经》,随着马王堆出土文物,江西海昏侯出土的相关文物,还有帛书老子等文物的校对。
发现我们当下熟知的《道德经》,很多地方的次序,断句,甚至有无颠倒,给篡改了。
咋一看到这个资料,很多人是惊呼的,原来自己多年朗朗上口,喜欢阅读的《道德经》是错的,是给人篡改的,读到了一本假的经书。
浪费了光阴,伤了心情,还不知道真的道德经到底是什么样?
当头一盆冷水,希望越大,越喜欢《道德经》,越认可,就伤得更深。
是不是真的读错了经书呢?以《道德经》为例。
也许,我们是过度担心了,当年老子李耳,早就考虑到后世出现的这样改来改去的情况。
所以,在斟酌经书内容的时候,早就设置了汉字的防痴呆体系,让我们这些愚蠢的后辈们,无论怎么读,无论怎么样去改,都能够读到原汁原味的《道德经》。
关于老子的预见性智慧,在《道德经》里面体现太多了。
金玉满堂,莫之能守。
急流勇退,功成身退。
小国寡民,老死不相往来。
诸如此类等等,都是关于人类走向的预见性篇章。
网络上,很多很火的大师们,用大白话在解析《道德经》也吸引了很多人,拆拆补补,整出很多让人耳目一新的道理来,其实也是旧瓶换新酒而已。
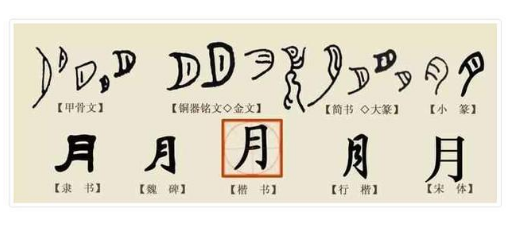
有人说,字母语系是一维的,而汉字语系是二维的。
其实,汉字不止二维,是多维度的。
比如,用1234,ABCD来表达,与甲乙丙丁来表达,大家可以品出一些不同吧。
对比2020年,和庚子年,哪一个可以解构出来更多时空数据来,高下立判。
未来的计算机发展,是不是可以发挥这种汉字表达的特点,发展新的计算机语言呢?
机器语言的特征就是严密的逻辑性,没有歧义,唯一的指定性,
很多人误以为,只有英语语境才能够形成严密的逻辑性,是机器语言的不二选项,
其实是一种文化的不自信,当英语作为计算机语言的结构时,必须要做很多规范工作,
从语言表达的长度,和标准化程度,中文更适合做为一项优秀的机器语言,
或者说,中文就是天然的机器语言。
同样的显示容量,用中文来表达是最节省字节的,显示效率最高,
而且,中文的每一个字所占的空间是一致的,一个字就是一个字,毫不含糊的标准化。
那种认为汉字表达歧义多的说法,其实是一种误解和误导。
难道,汉语体系就不能写说明书,就不能写操作说明了,就不能写法律文书了。
其实,可以更简洁,这简直是一种降维打击,那才是某些人难以接受的事实。
关注汉语体系中的防痴呆基因,关注隐士申子源的更多文章!